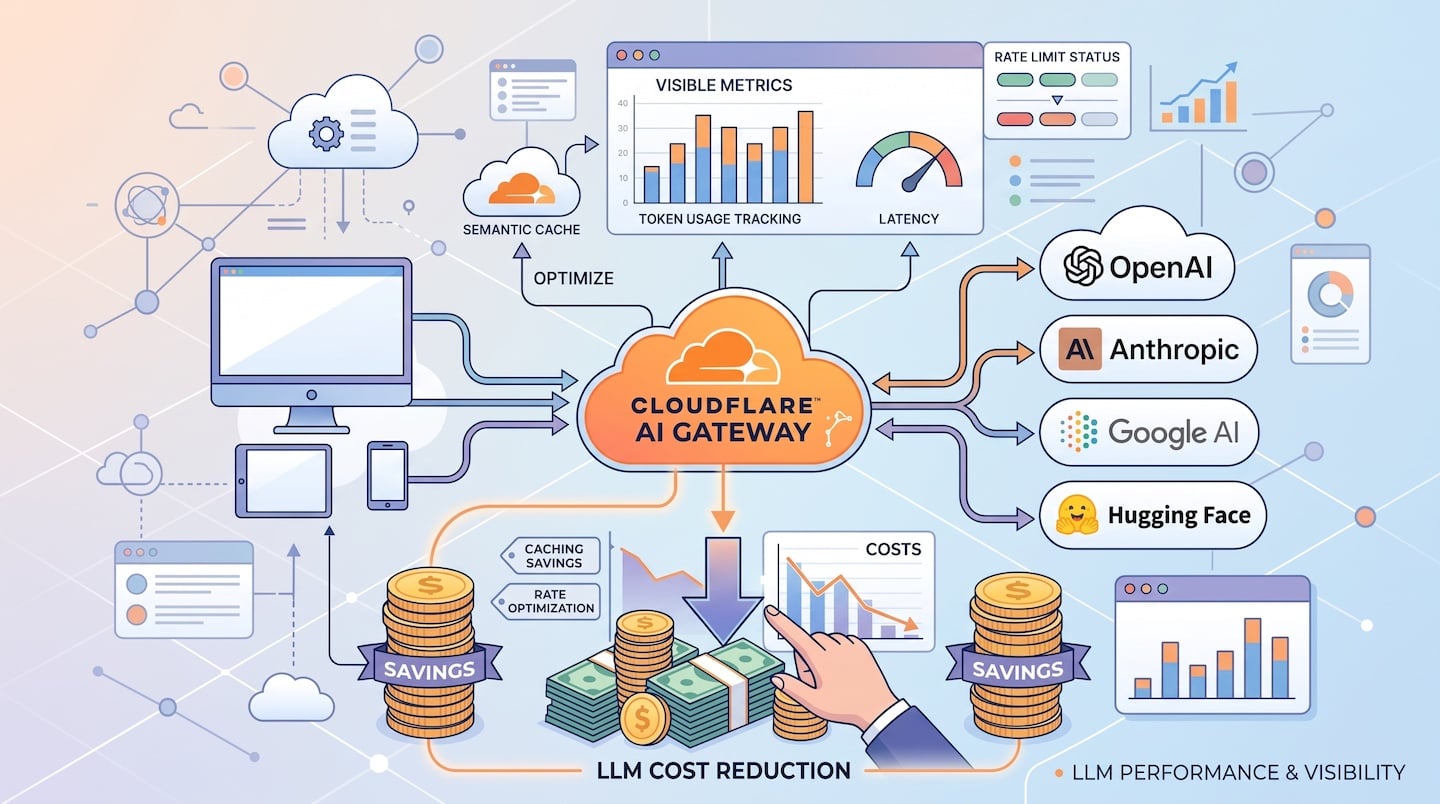
Webサイトや自社サービスに生成AI(LLM)機能を組み込む企業が急速に増える一方、多くの開発チームや事業責任者が「予想以上のAPI利用料の高騰」「レスポンス遅延(レイテンシ)」「API障害・レートリミットによるサービス停止」「トークン使用量の不透明さ」といった課題に直面しています。
これらの課題を、既存のアプリケーションコードをほとんど変更することなく一挙に解決するソリューションが、Cloudflareが提供する「Cloudflare AI Gateway」です。
本記事では、LLMのコスト構造の基礎から、AI Gatewayのメリット・デメリット、対応AIモデル、導入の手順、セマンティックキャッシュによるコスト削減手法までを分かりやすく解説します。
1. 前提知識:LLMと「利用コスト(トークン)」の仕組み
まずは、生成AI運用において「なぜコスト高騰が起きるのか」という基礎知識を整理します。
LLM(大規模言語モデル)とは?
LLM(Large Language Model)とは、膨大なテキストデータを学習し、人間のように自然な文章を理解・生成できるAIモデルです。代表的なものにOpenAIのGPT-4o、AnthropicのClaude 3.5 Sonnet、GoogleのGeminiなどがあります。
コスト決定の単位「トークン(Token)」とは?
Webサービス等にLLM APIを組み込んで利用する場合、多くは「従量課金制」となります。この計算単位となるのが「トークン」(テキストの最小単位)です。
- 入力(Input)トークン: ユーザーからの質問、システムプロンプト、参照ドキュメント(RAGなど)の文字数
- 出力(Output)トークン: LLMが生成して返した回答の文字数
一般的に、出力トークンは入力トークンの2〜4倍高額に設定されています。
LLM運用で直面しやすい3つの課題
- 重複リクエストへの無駄な課金: 「営業時間帯は?」といった多くのユーザーから届く同じような質問に対しても、毎回LLMを呼び出してフルでトークン費用が発生してしまう。
- 予期せぬコスト爆発: アクセス急増や、APIの無限ループ処理、長文プロンプトの多用により、毎月の請求額が跳ね上がるリスクがある。
- 複数プロバイダーの管理負担: OpenAIやAnthropicなど用途に応じて複数のAIを使い分ける際、全体でどれだけトークンを消費しているかの集計が困難になる。
2. Cloudflare AI Gatewayのメリット・デメリット
AI Gatewayの導入を検討する上で把握しておくべき主なメリットと注意点(デメリット)をまとめました。
メリット・デメリット比較表
| 項目 | メリット | デメリット・注意点 |
| コスト | セマンティックキャッシュによるAPI費用の劇的削減(キャッシュヒット時は$0) | ログの長期保存など、大量データ・エンタープライズ運用時は仕様の事前確認が必要 |
| 対応プロバイダー | OpenAI, Anthropic, Gemini, Azure, Bedrock等、主要なLLMを幅広く網羅 | マイナーな独自仕様APIの場合、設定やフォーマット変換の確認が必要な場合がある |
| 導入コスト | URL(Base URL)を変更するだけのノーコード/ローコード導入 | 既存の複雑なプロキシ構成とバッティングする場合、ネットワーク調整が必要 |
| パフォーマンス | エッジキャッシュによるレスポンスの超高速化(数10ms) | キャッシュ未ヒット時のわずかなレイテンシ追加(ミリ秒単位のリバースプロキシオーバーヘッド) |
| 運用・可用性 | 統合ダッシュボードでの可視化、自動フェイルオーバーによるダウンタイム防止 | 障害発生時、Cloudflare自体のステータス依存要因が1つ増える(SPOFリスクの考慮) |
| セキュリティ | レート制限による請求爆発の防止、APIキーの暗号化隠蔽 | リアルタイム性が極めて高い動的データへのセマンティックキャッシュ適用には設計調整が必要 |
メリットの詳細
- 大幅なAPIコスト削減(セマンティックキャッシュ)
類似した質問に対して過去の回答をキャッシュから即座に返却するため、AIプロバイダーへのトークン課金を $0 に抑えられます。 - 高速なレスポンス(レイテンシ低下)
LLMの生成処理には通常1〜5秒ほどかかりますが、Cloudflareのエッジネットワークからキャッシュ返却されることで数10ミリ秒(ms)レベルの爆速レスポンスを実現します。 - マルチLLM環境の「一元管理・可視化」
OpenAI、Anthropic、Geminiなど複数のプロバイダーを使っていても、トークン消費量、エラー率、概算コストを1つのダッシュボードで統合分析できます。 - サービス停止を防ぐ「自動フェイルオーバー」
メインのAI(例: OpenAI)で障害やレート制限(429 Too Many Requests)が発生した場合、自動的にサブのAI(例: Anthropic)へリクエストを切り替えるため、高可用性を維持できます。
デメリット・注意点の詳細
- わずかなオーバーヘッド(ネットワークレイテンシ)
リバースプロキシを経由する構造上、キャッシュがヒットしなかった初回のAPI呼び出しでは、数ミリ秒〜数十ミリ秒程度の通信オーバーヘッドが発生します(ただしLLM自体の処理時間に比べれば無視できるレベルです)。 - キャッシュ設計の考慮が必要
「毎秒変わるリアルタイム情報」や「個人の機密情報が含まれる会話」など、キャッシュすべきではないデータに対しては、適切にキャッシュをOFF(またはTTLを0)にする設定管理が必要です。 - Cloudflare依存度の上昇
システム構成にCloudflareを挟むため、非常に稀ではあるもののCloudflare側のネットワーク障害の影響を受ける可能性があります。
3. Cloudflare AI Gatewayとは?(プロキシとして挟むだけのノーコード/ローコード導入)
これらのコスト・運用課題をスマートに解決するのがCloudflare AI Gatewayです。
AI Gatewayの役割
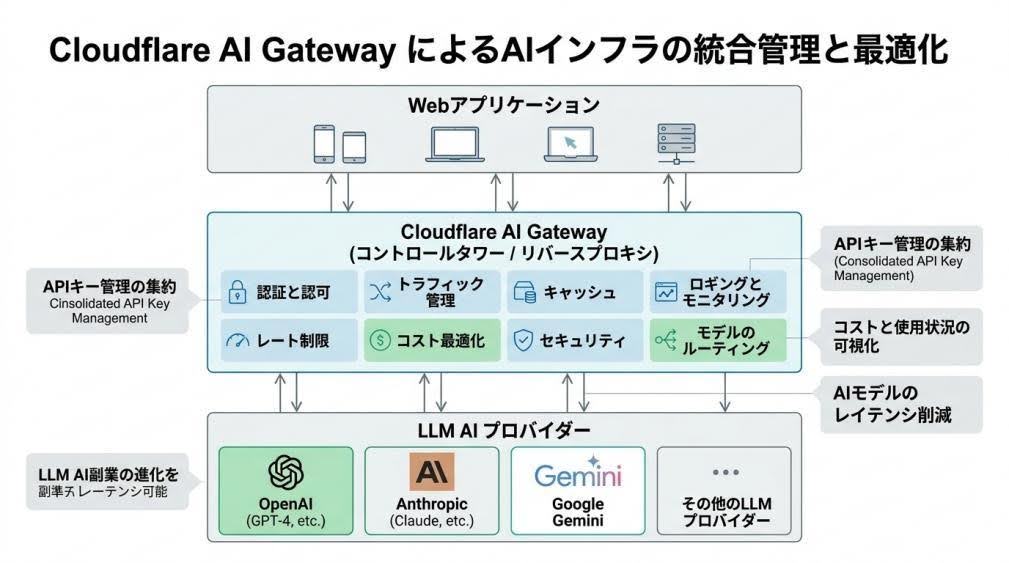
Cloudflare AI Gatewayは、自社のアプリケーションと、各種AIプロバイダー(OpenAI、Anthropic、Google Geminiなど)との間に配置する「制御タワー(リバースプロキシ)」です。
[ ユーザー / Webアプリ ]
│
▼
[ Cloudflare AI Gateway ] ── (プロキシ・キャッシュ・ログ・フェイルオーバー)
│
├──► OpenAI (GPT-4o / o3-mini)
├──► Anthropic (Claude 3.5 Sonnet)
├──► Google Gemini
└──► Azure OpenAI / Groq / Hugging Face など
アプリとAIプロバイダーの間にAI Gatewayを挟むことで、コントロール、可視化、キャッシュ、セキュリティ機能を一括適用できます。
【対応AIプロバイダー一覧】主要なLLMを網羅
Cloudflare AI Gatewayは、市場で利用されている主要なAIプロバイダーおよびプラットフォームに対応しています。
- 主要プロバイダー:
- OpenAI(GPT-4o, GPT-4o mini, o1, o3-mini など)
- Anthropic(Claude 3.5 Sonnet, Claude 3.5 Haiku など)
- Google Gemini(Gemini 1.5 Pro, Gemini 1.5 Flash など)
- クラウドインフラ・AIホスティング:
- Azure OpenAI Service
- AWS Bedrock
- Amazon Bedrock Converse
- Google Vertex AI
- 高速推論エンジン・オープンソースプラットフォーム:
- Groq
- Hugging Face
- Replicate
- Perplexity
- Cohere
- Workers AI(Cloudflare自社のエッジAIプラットフォーム)
※また、ユニバーサルエンドポイント機能やカスタムエンドポイント設定を利用することで、多様なサードパーティ製AI APIやオープンソースモデル(Llama 3等)とも柔軟に連携可能です。
導入の手順:エンドポイント(URL)を書き換えるだけ
AI Gatewayの最大の魅力は、導入の障壁が非常に低い(ノーコード/ローコード)点にあります。特別なSDKを追加インストールする必要はなく、API呼び出しのベースURL(Base URL)をAI Gatewayのものへ変更するだけで完了します。
【実装例:OpenAI Python SDKの場合】
従来のコード
Python
from openai import OpenAI
client = OpenAI(
api_key=”YOUR_OPENAI_API_KEY”
)
AI Gateway導入後のコード
Python
from openai import OpenAI
# Cloudflare AI Gatewayのエンドポイントに変更するだけ
client = OpenAI(
api_key=”YOUR_OPENAI_API_KEY”,
base_url=”https://gateway.ai.cloudflare.com/v1/{account_id}/{gateway_id}/openai”
)
既存のロジックやレスポンスの受け取り方は一切変更する必要がありません。
4. セマンティックキャッシュによるコスト削減の仕組み
LLM利用料を削減するコア機能が「セマンティックキャッシュ(Semantic Cache)」です。
完全一致キャッシュ vs セマンティックキャッシュ
- 従来のHTTPキャッシュ(完全一致): “Cloudflareの導入メリットは?” と “Cloudflareを導入するメリットは何ですか?” は、1文字でも異なると「別リクエスト」と判定され、キャッシュが効きません。
- セマンティックキャッシュ(意味的検索): プロンプトをベクトル化(Embedding)し、「意味の類似度」をリアルタイム判定します。表現や言い回しが微妙に異なっていても、同じ意図の質問であれば過去に生成した回答をキャッシュから即座に返却します。
[ ユーザーA ]: 「Cloudflareの料金体系は?」 ──► API実行 (1,000トークン消費 / 2.5秒)
│ (キャッシュ生成)
[ ユーザーB ]: 「Cloudflareの価格プランを教えて」 ─► [ AI Gateway (セマンティック判定) ]
│
└─► キャッシュから返答 (コスト$0 / 15ms)
類似度の判定閾値(Similarity Threshold)や有効期間(TTL)は、AI Gatewayのダッシュボードで柔軟にチューニング可能です。
5. ログ分析・レート制限・フェイルオーバーの運用活用
① 統一ダッシュボードによる可視化
リアルタイムで以下の指標を監視し、無駄なコストやエラーの原因を特定します。
- リクエスト数 & トークン消費量(Prompt / Completion Tokens)
- リアルタイム概算コスト
- エラー率(4xx / 5xx)
- プロンプト / レスポンスの監査ログ
② レート制限(Rate Limiting)による予期せぬ請求の防止
ユーザーIDやIPアドレスごとにリクエスト制限を設定できます。不正スクレイピングやプログラムのバグによる「APIの無限ループ・大量消費」をAI Gateway側で遮断します。
③ 自動フェイルオーバー(可用性の確保)
AI Gatewayの「Universal Endpoint」機能を活用すれば、OpenAIがダウンした際に自動でAnthropic(Claude)やAzure OpenAIに切り替えてレスポンスを返却できます。エンドユーザーにエラーを見せることなくサービスを継続可能です。
まとめ:Cloudflare AI Gatewayで賢く・安全に生成AIを運用しよう
生成AIの活用フェーズが「検証(PoC)」から「本格運用・商用化」へ移行するにつれ、コスト削減・レスポンス速度・運用可視化・可用性の4点は避けて通れない課題となります。
Cloudflare AI Gatewayは、OpenAI・Anthropic・Geminiなど主要なAIに一通り対応しており、既存システムのコード(Base URL)を変更するだけで導入できるため、コスト削減と運用安定化を迅速に実現することが可能です。
Web表示スピード改善・セキュリティ対策のCloudflare
導入のご相談だけでなく、運用フェーズでのサポートも承ります。
DDoS攻撃や悪質なBot(ボット)からのアクセスを防ぎたい方、WAF機能やプランの詳細を知りたい方、
国内エンジニアによる安心の運用サポートをご希望の方も、ぜひお気軽にお問い合わせください。